食物、刺激还是药物?多巴胺线索信号映出不同奖励偏好
小鼠研究发现,预告奖励的线索信号与个体选择紧密联系,并随着奖励强度和风险发生变化。
面对相同奖励,不同个体可能做出不同选择。有些偏好食物,有些更愿意追求人工刺激或药物,这种差异如何在大脑中体现?2026 年《Nature Neuroscience》的一项研究比较脂肪奖励、光遗传自刺激与可卡因,追踪伏隔核多巴胺信号。结果将注意力从奖励到来时的峰值,转向提前预告奖励的线索:经过学习,线索获得的信号与个体偏好紧密联系,也会随着代价与风险而改变。
单项采样中的奖励线索多巴胺差异,与随后选择偏好相关;奖励增强及风险引入时,这些信号呈现不同的更新轨迹。
阅读目录 · 6个部分
从奖励反应走向学得的价值
自然奖励与人工奖励之间的比较,为观察个体差异提供了窗口。研究中的自然奖励是脂肪溶液,人工选项包括多巴胺神经元光遗传自刺激或可卡因。小鼠分别学习线索、按杆和奖励之间的联系,再在两项选择中表达偏好。食物并未受到限制,试次数也得到控制,以减少饥饿或饱腹的影响。
伏隔核多巴胺记录来自交错的单项采样试次,选择试次则给出偏好。两类观察让研究者追踪不同奖励在学习中获得的信号,再看这些差异与之后的选择如何对应。由此,奖励造成的即时反应与学习形成的预期,成为可以放在一起比较的两个层面。
偏好更贴近线索信号
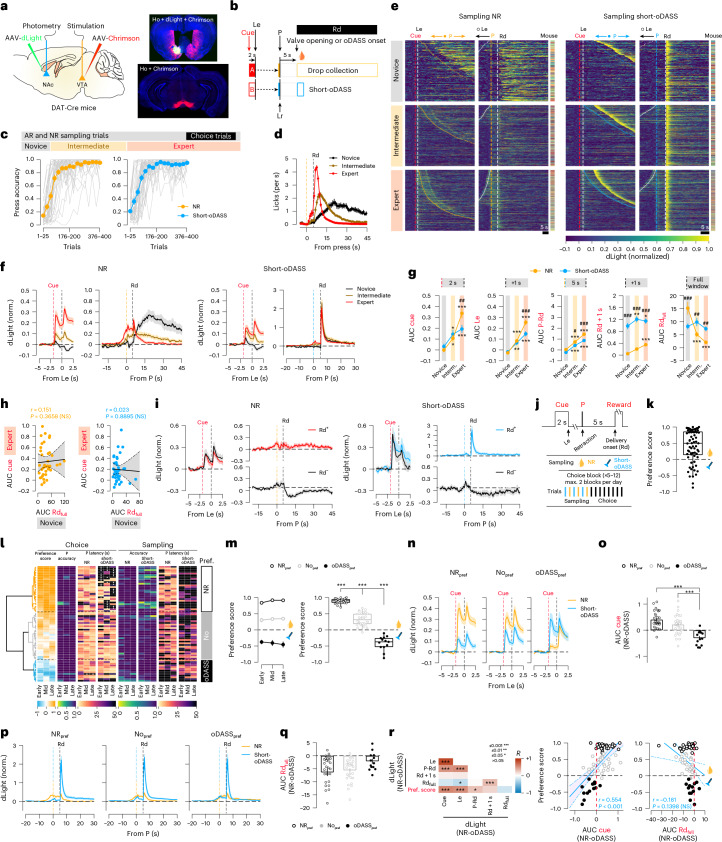
学习初期,自然奖励递送引发明显多巴胺响应;熟练后,递送响应减弱,预测线索的响应出现。光遗传奖励也形成线索信号,但奖励刺激时的多巴胺响应持续存在。两类条件中,预期奖励被遗漏时都会出现信号下降,与预测误差的解释相容。
有趣的是,初学时递送峰的大小没有预测熟练后的线索信号。自然与人工奖励的线索差值,却与随后偏好强相关,递送信号没有相同关系。奖励的即时强度与学得的预期价值因此呈现不同图景:对于理解个体选择,预告奖励时发生的变化格外值得关注。
来源:Pascoli V et al. · Nature Neuroscience · CC BY
查看原图与英文图注 ↗
增强奖励与重复体验,带来不同结果
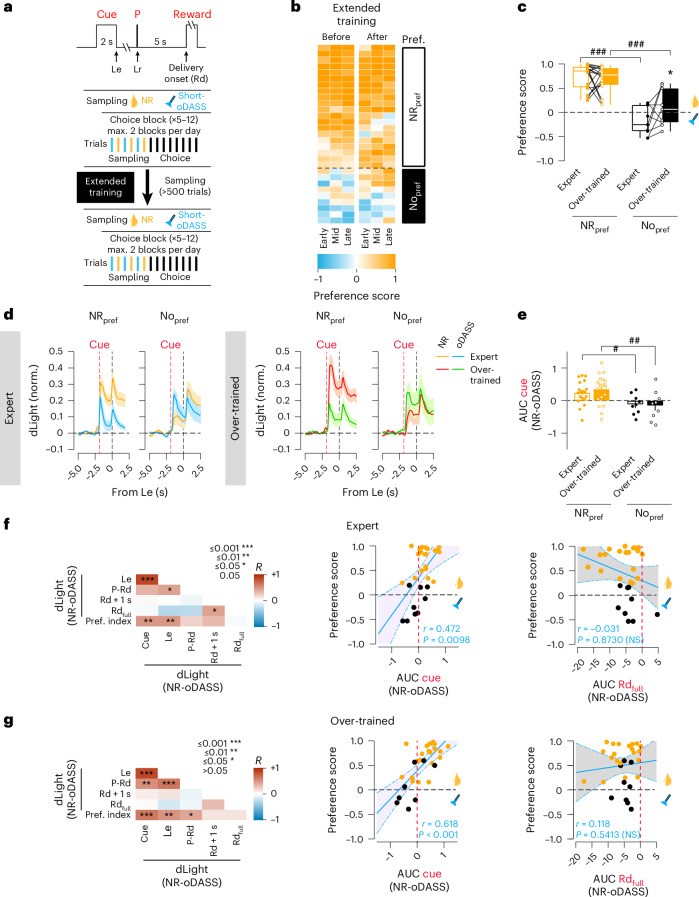
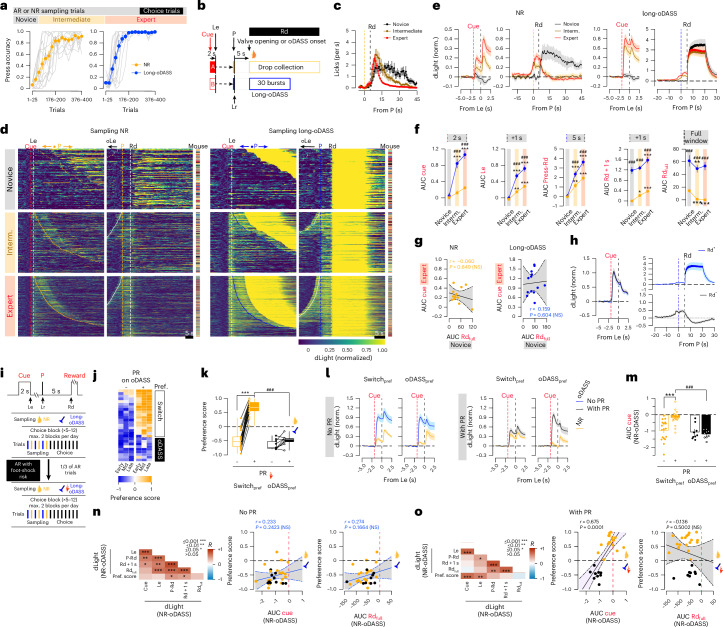
延长光奖励后,递送响应与相关线索信号提高,部分小鼠从自然奖励转向光奖励。仍有动物坚持自然奖励,显示更强的人工刺激并未统一所有个体的选择。线索信号与偏好轨迹一起变化,描绘出价值更新中的个体差异。
单纯增加短光奖励的体验则呈现另一种结果。经过四周、五百余次奖励,递送多巴胺持续存在,线索信号没有显著增强,偏好也保持稳定。重复体验与增强奖励并不等价:持续的递送响应,没有在这里转化为不断累积的线索价值。
来源:Pascoli V et al. · Nature Neuroscience · CC BY
查看原图与英文图注 ↗
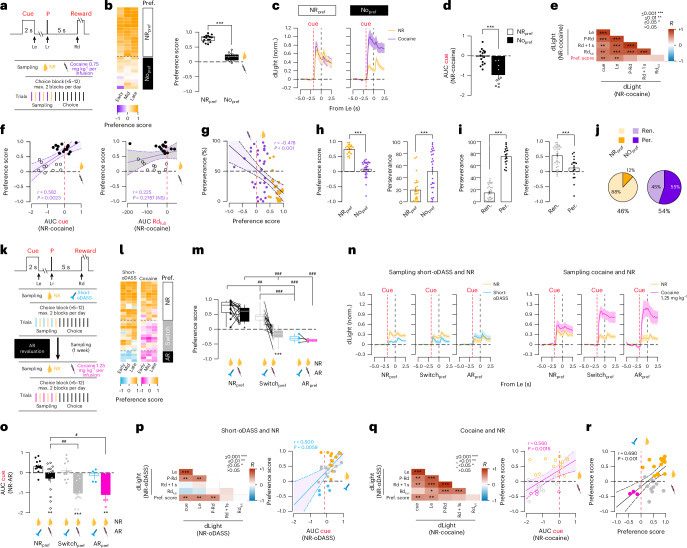
可卡因也保留了个体选择差异
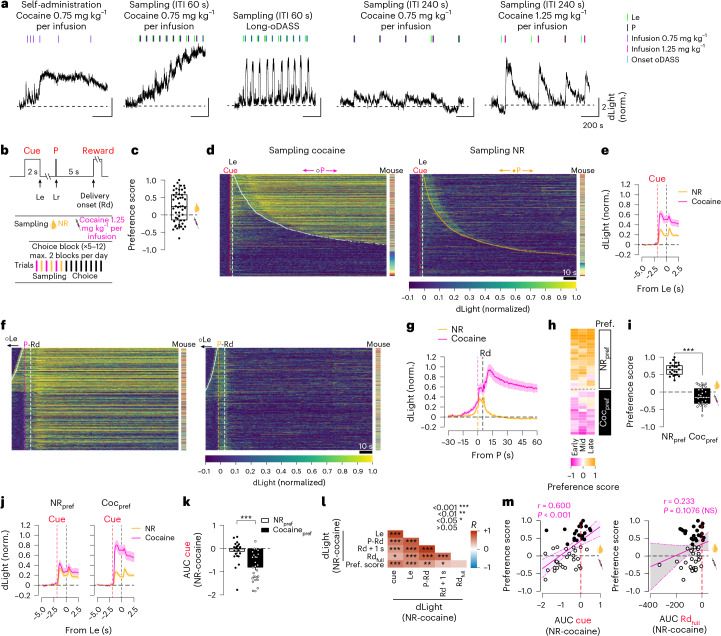
可卡因递送引发的多巴胺响应持续数分钟,与光刺激的时间过程不同。其线索信号同样与个体偏好相关。较强药物奖励通常伴随更高的群体线索响应,仍有不少动物偏好自然奖励。明显的多巴胺递送响应,因而没有让每只小鼠做出相同选择。
不同奖励还具有不同的时延与获得方式:药物有药代过程,光刺激更为直接,自然奖励需要移动和收集。这些条件共同构成当前任务中的价值背景。跨越不同奖励形式,研究反复观察到线索信号与偏好的联系,使学得的预期成为一条贯穿比较的线索。
来源:Pascoli V et al. · Nature Neuroscience · CC BY
查看原图与英文图注 ↗
多数动物更新,部分动物坚持
当较强光奖励带上轻度电击风险,多数小鼠转向自然奖励,人工奖励线索的相对多巴胺信号减弱。另一些动物继续偏好光奖励,线索信号保持较高。代价进入选择之后,动物与信号出现不同轨迹,展现了价值更新中的可变性。
奖励递送峰没有同样区分这两类动物,线索则能够反映成本加入后的差异。试次级反应潜伏期与线索信号的联系较弱,也显示每次行动仍受到其他情境与动机影响。个体偏好、学习预期与即时行动共同构成了选择过程的不同层面。
来源:Pascoli V et al. · Nature Neuroscience · CC BY
查看原图与英文图注 ↗
偏好与持续寻求之间,有着更细致的关系
对较弱人工奖励的偏好,与后来在惩罚下持续自刺激或转向较强可卡因奖励的倾向相关。强光奖励在无惩罚时的偏好,与后续持续行为则没有显著相关;惩罚加入后的选择联系更强。有些人工奖励偏好动物后来并未持续寻求,部分持续动物在有替代选项时仍选择自然奖励。
研究包含雌雄小鼠,荧光信号未发现显著性别差异。它将奖励递送、学得价值与风险下的更新放入同一框架,也为后续直接研究线索信号的作用提供了问题。个体为何坚持、又在何时改变选择,因而获得了比单看多巴胺峰值更丰富的解释。
来源:Pascoli V et al. · Nature Neuroscience · CC BY
查看原图与英文图注 ↗